联系:手机/微信(+86 17813235971) QQ(107644445)
作者:惜分飞©版权所有[未经本人同意,不得以任何形式转载,否则有进一步追究法律责任的权利.]
一套运行在aix环境的的10.2.0.4 rac库,由于异常断电导致数据库无法正常启动,报错为ORA-00600 6101。alert日志报错如下
Tue Oct 13 18:32:04 2026
ALTER DATABASE OPEN
This instance was first to open
Tue Oct 13 18:32:04 2026
Beginning crash recovery of 1 threads
 parallel recovery started with 15 processes
Tue Oct 13 18:32:08 2026
Started redo scan
Tue Oct 13 18:32:08 2026
Completed redo scan
 2573 redo blocks read, 396 data blocks need recovery
Tue Oct 13 18:32:08 2026
Started redo application at
 Thread 2: logseq 61170, block 1720185
Tue Oct 13 18:32:08 2026
Recovery of Online Redo Log: Thread 2 Group 4 Seq 61170 Reading mem 0
  Mem# 0: /oracle/oradata/db_ro41_1g
  Mem# 1: /oracle/oradata/db_ro42_1g
Tue Oct 13 18:32:08 2026
RECOVERY OF THREAD 2 STUCK AT BLOCK 63042 OF FILE 3
Tue Oct 13 18:32:08 2026
RECOVERY OF THREAD 2 STUCK AT BLOCK 38304 OF FILE 3
Tue Oct 13 18:32:08 2026
Errors in file /oracle/admin/orcl/bdump/orcl1_p001_123772.trc:
ORA-00600: internal error code, arguments: [6101], [16], [728], [32], [], [], [], []
Tue Oct 13 18:32:08 2026
Hex dump of (file 3, block 61217) in trace file /oracle/admin/orcl/bdump/orcl1_p013_254256.trc
Corrupt block relative dba: 0x00c0ef21 (file 3, block 61217)
Bad header found during crash/instance recovery
Data in bad block:
 type: 6 format: 1 rdba: 0x000000c0
 last change scn: 0x4f2b.ef213393 seq: 0xd flg: 0xe1
 spare1: 0x20 spare2: 0xa2 spare3: 0x41c5
 consistency value in tail: 0x00004f2b
 check value in block header: 0x104
 block checksum disabled
Reread of rdba: 0x00c0ef21 (file 3, block 61217) found same corrupted data
 from side
Reread of rdba: 0x00c0ef21 (file 3, block 61217) found same corrupted data
 from side
………………一直循报file 3 block 61217坏块错误
对于这种情况,尝试人工recover datafile文件
SYS@orcl1>recover datafile 1;
Media recovery complete.
SYS@orcl1>recover datafile 2;
Media recovery complete.
SYS@orcl1>recover datafile 4,5,6,7,8,9;
ORA-00283: recovery session canceled due to errors
ORA-12805: parallel query server died unexpectedly


SYS@orcl1>recover datafile 4;
Media recovery complete.
SYS@orcl1>recover datafile 6,7,8,9;
Media recovery complete.
SYS@orcl1>recover datafile 10,11,12,13,14;
ORA-00279: change 15260723994623 generated at 12/10/2024 06:52:06 needed for thread 2
ORA-00289: suggestion : /oracle/db10g/dbs/arch/2_61129_726871555.dbf
ORA-00280: change 15260723994623 for thread 2 is in sequence #61129


Specify log: {<RET>=suggested | filename | AUTO | CANCEL}
cancel
Media recovery cancelled.
SYS@orcl1>recover datafile 10,11,12,14;
Media recovery complete.
SYS@orcl1>recover datafile 15,16,17,19,20,21,22,23,24,25;
Media recovery complete.
SYS@orcl1>recover datafile 26,27,28,29,30,32,31;
Media recovery complete.
这里有几个文件没有recover 成功,有些是坏块,有些是缺少归档,对于这种情况一般有两种处理思路:
1. 通过屏蔽一致性,强制把库拉起来
2. 通过bbed修改文件头,然后直接正常open库,这里我们选择了第二种方法,把异常的几个数据文件头状态修改和file 1的一样(这里为什么没有使用obet(Oracle Block Editor Tool),不是obet没有这个功能,是由于obet我没有在aix平台进行编译)
BBED> set file 1
        FILE#           1

BBED> p kcvfh.kcvfhckp
struct kcvfhckp, 160 bytes                  @484
   struct kcvcpscn, 8 bytes                 @484
      ub4 kscnbas                           @484      0x3393501d
      ub2 kscnwrp                           @488      0x0de1
   ub4 kcvcptim                             @492      0x492a5f83
   ub2 kcvcpthr                             @496      0x0002
   union u, 12 bytes                        @500
      struct kcvcprba, 12 bytes             @500
         ub4 kcrbaseq                       @500      0x0000eef2
         ub4 kcrbabno                       @504      0x001a4986
         ub2 kcrbabof                       @508      0x0010


BBED> set file 3
        FILE#           3

BBED> p kcvfh.kcvfhckp
struct kcvfhckp, 160 bytes                  @484
   struct kcvcpscn, 8 bytes                 @484
      ub4 kscnbas                           @484      0x338943b6
      ub2 kscnwrp                           @488      0x0de1
   ub4 kcvcptim                             @492      0x491973d8
   ub2 kcvcpthr                             @496      0x0002
   union u, 12 bytes                        @500
      struct kcvcprba, 12 bytes             @500
         ub4 kcrbaseq                       @500      0x0000eef2
         ub4 kcrbabno                       @504      0x00000002
         ub2 kcrbabof                       @508      0x0010
然后对这些异常文件进行recover 操作
SYS@orcl1>recover datafile 3;
Media recovery complete.
SYS@orcl1>recover datafile 5;
Media recovery complete.
SYS@orcl1>recover datafile 13,18;
Media recovery complete.


Mon Nov  2 10:32:05 2026
ALTER DATABASE RECOVER  datafile 3
Mon Nov  2 10:32:05 2026
Media Recovery Start
 parallel recovery started with 15 processes
Mon Nov  2 10:32:07 2026
Recovery of Online Redo Log: Thread 2 Group 4 Seq 61170 Reading mem 0
  Mem# 0: /oracle/oradata/db_ro41_1g
  Mem# 1: /oracle/oradata/db_ro42_1g
Mon Nov  2 10:32:07 2026
Recovery of Online Redo Log: Thread 1 Group 2 Seq 107734 Reading mem 0
  Mem# 0: /oracle/oradata/db_ro21_1g
  Mem# 1: /oracle/oradata/db_ro22_1g
Mon Nov  2 10:32:07 2026
Media Recovery Complete (orcl1)
Completed: ALTER DATABASE RECOVER  datafile 3
Mon Nov  2 10:32:16 2026
ALTER DATABASE RECOVER  datafile 5
Media Recovery Start
 parallel recovery started with 15 processes
Mon Nov  2 10:32:16 2026
Recovery of Online Redo Log: Thread 2 Group 4 Seq 61170 Reading mem 0
  Mem# 0: /oracle/oradata/db_ro41_1g
  Mem# 1: /oracle/oradata/db_ro42_1g
Mon Nov  2 10:32:16 2026
Recovery of Online Redo Log: Thread 1 Group 2 Seq 107734 Reading mem 0
  Mem# 0: /oracle/oradata/db_ro21_1g
  Mem# 1: /oracle/oradata/db_ro22_1g
Mon Nov  2 10:32:16 2026
Media Recovery Complete (orcl1)
Completed: ALTER DATABASE RECOVER  datafile 5
Mon Nov  2 10:32:22 2026
ALTER DATABASE RECOVER  datafile 13,18
Media Recovery Start
 parallel recovery started with 15 processes
Mon Nov  2 10:32:22 2026
Recovery of Online Redo Log: Thread 2 Group 4 Seq 61170 Reading mem 0
  Mem# 0: /oracle/oradata/db_ro41_1g
  Mem# 1: /oracle/oradata/db_ro42_1g
Mon Nov  2 10:32:22 2026
Recovery of Online Redo Log: Thread 1 Group 2 Seq 107734 Reading mem 0
  Mem# 0: /oracle/oradata/db_ro21_1g
  Mem# 1: /oracle/oradata/db_ro22_1g
Mon Nov  2 10:32:22 2026
Media Recovery Complete (orcl1)
Completed: ALTER DATABASE RECOVER  datafile 13,18
直接打开数据库
$ sqlplus / as sysdba

SQL*Plus: Release 10.2.0.4.0 - Production on Mon Nov 2 10:33:27 2026

Copyright (c) 1982, 2007, Oracle.  All Rights Reserved.


Connected to:
Oracle Database 10g Enterprise Edition Release 10.2.0.4.0 - 64bit Production
With the Partitioning, Real Application Clusters, OLAP, Data Mining
and Real Application Testing options

SYS@orcl1>set pages 10000
SYS@orcl1>set numw 16
SYS@orcl1>SELECT status,
  2  checkpoint_change#,
  3  to_char(checkpoint_time,'yyyy-mm-dd hh24:mi:ss') checkpoint_time,
  4  last_change#,
  5  count(*) ROW_NUM
  6  FROM v$datafile
  7  GROUP BY status, checkpoint_change#, checkpoint_time,last_change#
  8  ORDER BY status, checkpoint_change#, checkpoint_time;

STATUS  CHECKPOINT_CHANGE# CHECKPOINT_TIME         LAST_CHANGE#          ROW_NUM
------- ------------------ ------------------- ---------------- ----------------
ONLINE      15260884095005 2026-03-10 08:02:11   15260884095005               27
ONLINE      15260884095006 2026-03-10 08:02:11   15260884095006                4
SYSTEM      15260884095005 2026-03-10 08:02:11   15260884095005                1

SYS@orcl1>
SYS@orcl1>
SYS@orcl1>set numw 16
SYS@orcl1>col CHECKPOINT_TIME for a40
SYS@orcl1>set lines 150
SYS@orcl1>set pages 1000
SYS@orcl1>SELECT status,
  2  to_char(checkpoint_time,'yyyy-mm-dd hh24:mi:ss') checkpoint_time,FUZZY,checkpoint_change#,
  3  count(*) ROW_NUM
  4  FROM v$datafile_header
  5  GROUP BY status, checkpoint_change#, to_char(checkpoint_time,'yyyy-mm-dd hh24:mi:ss'),fuzzy
  6  ORDER BY status, checkpoint_change#, checkpoint_time;

STATUS  CHECKPOINT_TIME                          FUZ CHECKPOINT_CHANGE#          ROW_NUM
------- ---------------------------------------- --- ------------------ ----------------
ONLINE  2026-03-10 08:02:11                      NO      15260884095005               28
ONLINE  2026-03-10 08:02:11                      NO      15260884095006                4

SYS@orcl1>alter database open;

Database altered.
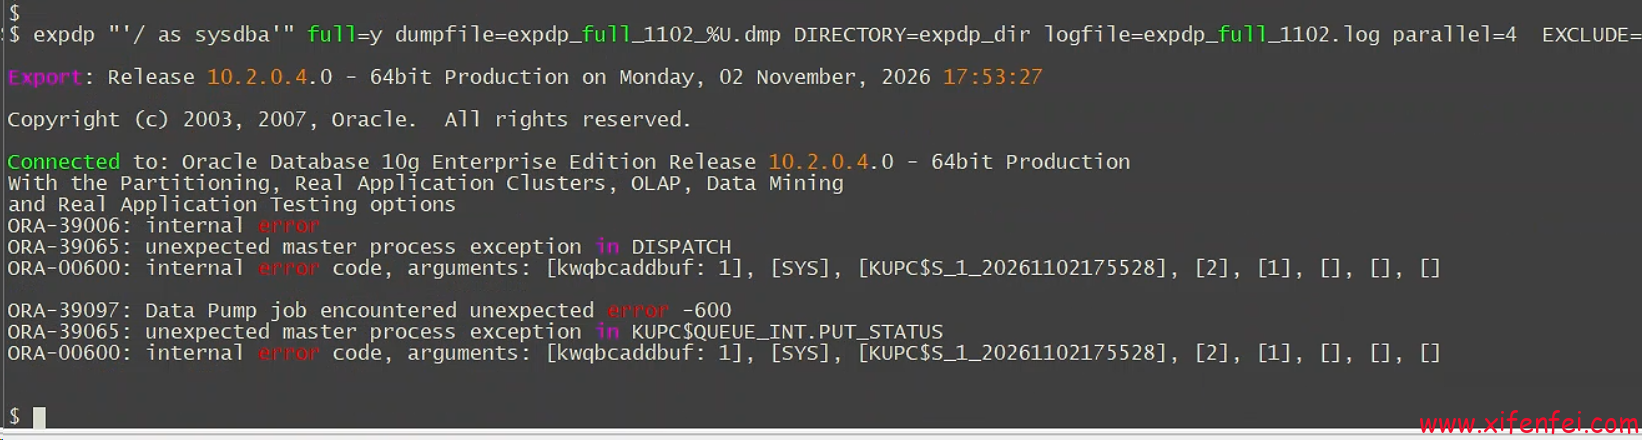
然后尝试expdp导出数据报ORA-600 kwqbcaddbuf: 1错误
$ expdp "'/ as sysdba'" full=y dumpfile=expdp_full_1102_%U.dmp DIRECTORY=expdp_dir logfile=expdp_full_1102.log
> parallel=4  EXCLUDE=STATISTICS,AUDIT

Export: Release 10.2.0.4.0 - 64bit Production on Monday, 02 November, 2026 10:38:48

Copyright (c) 2003, 2007, Oracle.  All rights reserved.

Connected to: Oracle Database 10g Enterprise Edition Release 10.2.0.4.0 - 64bit Production
With the Partitioning, Real Application Clusters, OLAP, Data Mining
and Real Application Testing options
ORA-39006: internal error
ORA-39065: unexpected master process exception in DISPATCH
ORA-00600: internal error code, arguments: [kwqbcaddbuf: 1], [SYS], [KUPC$S_1_20261102104051], [2], [1], [], [], []

ORA-39097: Data Pump job encountered unexpected error -600
ORA-39065: unexpected master process exception in KUPC$QUEUE_INT.PUT_STATUS
ORA-00600: internal error code, arguments: [kwqbcaddbuf: 1], [SYS], [KUPC$S_1_20261102104051], [2], [1], [], [], []
通过rebuild datapump程序
@?/rdbms/admin/catdph.sql
@?/rdbms/admin/catmetx.sql
@?/rdbms/admin/prvtdtde.plb
@?/rdbms/admin/catdpb.sql
@?/rdbms/admin/dbmspump.sql
@?/rdbms/admin/utlrp.sql
实现expdp程序可以正常导出数据